Die KI-Modelle können – mit etwas Unterstützung – verdammt guten Inhalt bauen. Wer als Content-Creator, Journalist:in oder Autor:in weiterhin eine Rolle spielen möchte, muss sich also etwas überlegen. Ein Vorschlag: weg vom fertigen Artikel, hin zu einem Datenkern, aus dem Formate bei Bedarf entstehen. Ich zeige dir, was „Liquid Content“ tatsächlich bedeutet, woran viele KI-Projekte in Redaktionen scheitern — und wie du in überschaubaren Schritten anfängst.
Das Loch im Geschäftsmodell
Webseiten – vor allem die mit durchschnittlichem Inhalt – haben es schwer und werden es in Zukunft noch schwerer haben. Das eigentliche Problem: Publisher aller Art produzieren Content, um Content zu verkaufen. Anders Händler, Krankenkassen oder Handwerker. Die produzieren Content, um Produkte, Versicherungen oder eine Solaranlage zu verkaufen. Das klingt nach einer semantischen Spitzfindigkeit, zeigt aber einen zentralen ökonomische Unterschied.
Während die einen mit dem Inhalt nur auf sich aufmerksam machen möchten und ihre Marge in anderen Produkten realisieren, verdienen Publisher ihr Geld mit dem Content. Und dann kommt die unangenehme Wahrheit: Die LLMs haben unsere Inhalte längst verarbeitet. Alle Inhalte hier stecken schon längst in ChatGPT und unterstützen die KI-Konzerne dabei, Geld zu verdienen.
Bevor der Abgesang losgeht: Das ist kein Plädoyer gegen Journalismus und Publishern stehen noch sehr gute Zeiten bevor. Gute Reportagen, Kolumnen, Interviews, Kommentare — all das kann KI momentan nicht, und wahrscheinlich auch in Zukunft nicht auf einem Niveau, das mit starkem Handwerk mithält. Was wir aber attestieren müssen: Durchschnittlicher Auftragscontent, der über den Zaun geworfen wird, rechnet sich nicht mehr. Weder für Verlage noch für freie Journalistinnen.
Was Liquid Content nicht ist
Also „Liquid Content“? Einfach aus einem Stück Content noch eine Audioversion, ein Video und ein FAQ bauen? Also einfach mehr machen und hoffen, es passt?
Das ist der falsche Ansatz. Oder präziser: Es ist ein Ansatz, der dich in einer Komplexitätsfalle landen lässt.
Denn in dem Moment, in dem aus einem Artikel fünf Formate werden sollen, brauchst du fünf Workflows, fünf Abstimmungsrunden, fünf Qualitätskontrollen. Und was, wenn du den Artikel nächste Woche aktualisierst? Dann musst du alle fünf Formate nachziehen. Das skaliert nicht. Das organisiert sich selbst in die Erschöpfung.
Liquid Content heißt nicht „ein Stoff, viele Formate“. Liquid Content heißt: ein Datenkern, aus dem Formate bei Bedarf entstehen.
Der Core-Asset-Ansatz: Was wirklich gemeint ist
Stell dir in der Mitte deiner Architektur keinen Artikel (oder viele Artikel) mehr vor, sondern einen Datenkern. In diesen Kern fließt alles, was du weißt und recherchiert hast:
- Bestehende Inhalte (Artikel, Blogposts, Dossiers)
- Recherchen — auch die unveröffentlichten
- Transkripte, Notizen, Expertengespräche
- Feedback, das dir Nutzer gegeben haben
- Externes, frei verfügbares Material (Leitlinien, offene Daten)
Rund um diesen Kern baust du Ausleitungen: Eine Webseite, einen Newsletter, einen Podcast, eine Social-Präsenz, einen Chat. Aber — und das ist der Punkt — die Ausleitungen greifen auf denselben Kern zu. Du schreibst nicht mehr parallel fünfmal dieselbe Geschichte. Du pflegst einen Kern und ziehst daraus bei Bedarf die Formate heraus, die funktionieren.
Das ist nicht wirklich neu: Als ich früher als freier Journalist für viele große Magazin gearbeitet habe, musste ich tagelang zum Beispiel die Roaming-Tarife in Europa recherchieren und strukturieren, um den Urlaubern gute Spartipps für den Urlaub zu geben. Dazu kamen noch Interviews mit den Providern und Hardware-Tipps. Mein Vorteil: Ich schrieb damals für viele große Magazine und konnte dadurch für viele Artikel auf diese umfassende Recherche zugreifen. Mit meinem Core-Asset-Ansatz (dieser war damals Excel ;-)) blieb diese Arbeit abrufbar und anpassbar.
Vertausche nun die die Magazine mit verschiedenen Formaten und Kanälen und du hast „Liquid Content“. Die Recherche wird zum Rohstoff für andere Formate, für Chat-Antworten, für einen Follow-up-Artikel, für einen Podcast-Dialog. Das ist der eigentliche ökonomische Hebel.
Deine Rolle verändert sich — aber anders, als du denkst
Die Publisher stehen vor einer großen Herausforderung. Gefährdet sind aber vor allem die Tätigkeiten, die durchschnittlichen Content produzieren. Also: Auftragsartikel, die nach Schema F runtergeschrieben werden, Content-Marketing-Texte auf Bestellung, SEO-Füllmaterial. Das kann eine gut promptete KI heute schon, und übermorgen noch besser. Wer das heute noch macht, sollte sich beruflich neu orientieren. Ja, das meine ich ernst.
Weniger gefährdet sind dagen Tätigkeiten, die besonderen Content produzieren. Kolumnen, Reportagen, Interviews, Kommentare, Streitgespräche. Alles, wo eine Haltung, ein Stil, eine Beobachtungsgabe dranhängt, die aus einem Menschen kommt.
Und es gibt eine neue Kategorie: Content-Architektinnen und Content-Architekten. Menschen, die Inhalte nicht mehr nur schreiben, sondern Systeme bauen, in denen Inhalte verwertbar bleiben. Die Kernkompetenzen sind: recherchieren, kuratieren, beraten, Formate entwickeln und testen. Dazu gehört Experimentierbereitschaft — und der Mut, in kleinen, gemischten Teams zu arbeiten statt in großen Stuhlkreisen.
Das Dreieck: Reichweite, Bindung, Geld
Bevor du anfängst zu bauen, brauchst du ein strategisches Gerüst. Dein Content bewegt sich in den Kanälen zwischen den drei Ecken hier – und für jedes Feld brauchst du mindestens ein Tool bzw. einen Kanal:
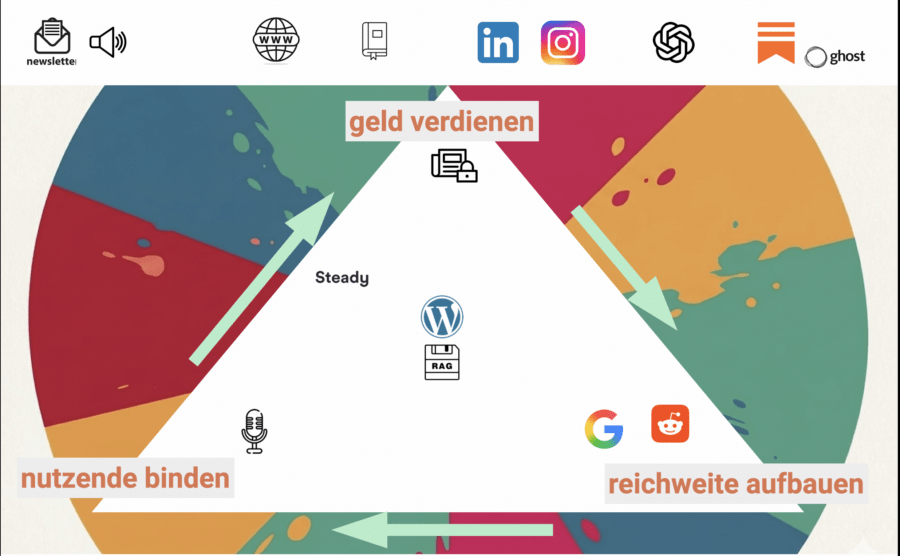
- Reichweite aufbauen — Wie werden Menschen überhaupt auf dich aufmerksam? In diesem Fall durch SEO und Reddit.
- Nutzende binden — Wie machst du aus Besuchern eine Beziehung? Das kann ein Newsletter oder ein Podcast sein. Oder einfach ein Login.
- Monetarisieren — Wie wird daraus Umsatz? Wenn deine Inhalte es schaffen, dass sie abonniert werden, ist das sehr gut. Sonst sind es vielleicht Workshops oder andere Geschäftsmodelle, die für die Finanzierung sorgen.
Der Reiz liegt in der Zirkularität. Aus Reichweite wird Bindung, aus Bindung wird Umsatz. Und wenn du die gebundenen Nutzerinnen gut behandelst, werden sie dir neue Reichweite bringen. Das Dreieck schließt sich zu einem Kreislauf.
Entscheidend ist nicht, welche Tools du nimmst, sondern dass alle drei Ecken besetzt sind. Ein reiner Reichweitenkanal ohne Bindung versandet. Eine reine Bezahlschranke ohne Reichweite verhungert. Und in der Mitte – da bin ich Traditionalist – steht deine Webseite, vielleicht technisch ein RAG.
Und: Weniger Kanäle sind die Lösung, nicht mehr. Wer 18 Tools parallel bespielt, verbringt den Tag mit Tool-Pflege statt mit Content. Drei Tools, die sauber ineinandergreifen, schlagen zehn, die nebeneinander herlaufen.
Der ketzerische Twist: Vergesst die Zielgruppenanalyse
Jetzt wird es unbequem. Wenn du in den letzten Monaten eine Zielgruppenanalyse beauftragt (oder deine KI danach befragt) hast, schlage ich vor, dass du diese wieder wegwirfst.
Nicht, weil Zielgruppenanalysen grundsätzlich schlecht wären. Sondern weil wir uns gerade in einem Bach befinden, der reißend schnell ist. Selbst wenn dabei viele Menschen tief interviewt wurden: Woher sollen die denn wissen, was sie in sechs Monaten brauchen, wenn sie heute noch herausfinden, was ChatGPT für sie bedeutet?
Mein Vorschlag als Alternative — und ja, das ist mein Twist, mein bewusst gegen den Strich gebürsteter Punkt:
Nicht von der Zielgruppe her denken, sondern von der Schnittmenge aus drei Fragen:
- Was kannst du richtig gut?
- Was macht dir maximal Spaß — also: wofür würdest du auch am Wochenende Zeit aufwenden?
- Wofür wären Menschen bereit, Geld zu bezahlen?
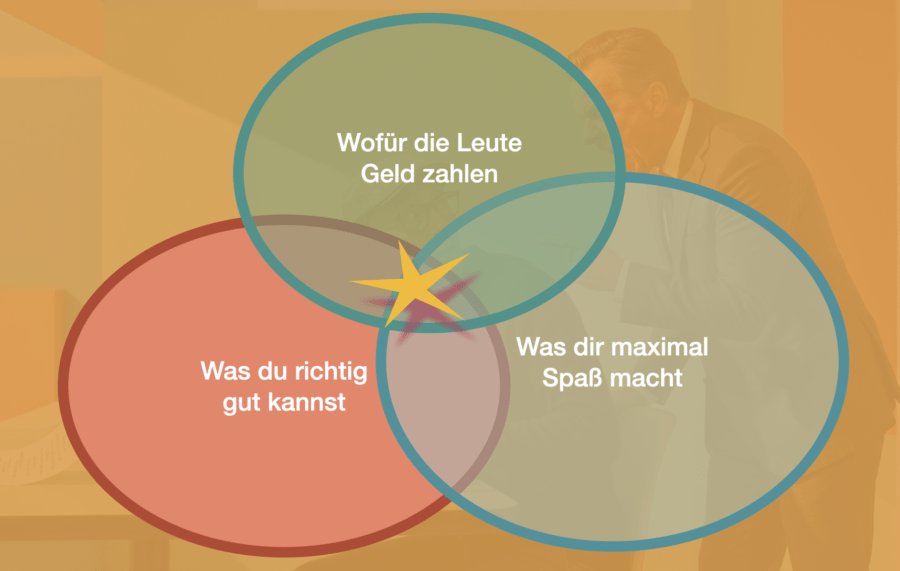
Die Schnittmenge ist deine Nische. Sie muss nicht riesig sein. Im deutschsprachigen Raum leben rund 100 Millionen Menschen. Eine Million Menschen sind, gemessen daran, eine kleine Nische. Aber selbst von dem Interesse von 10.000 Menschen kannst du sehr gut leben.
Natürlich musst du schon danach schauen, wofür die Menschen gerne zahlen. Aber schau auf dich selbst oder die Leute um dich her: Wofür geben die Geld aus? Und eines steht fest: Wenn du etwas tust, was du nicht gerne machst oder womöglich gar nicht gut machst, wirst du keinen Erfolg haben.
Ach noch eins: Was willst du explizit nicht machen? Ich weiß zum Beispiel, dass ich keinen Podcast machen werde. Ich höre mich ungern reden. Das zu wissen, spart Monate falscher Versuche.
Wie du anfängst: Vom Notebook LM zum eigenen RAG
Kurze Einordnung vorweg: RAG steht für Retrieval Augmented Generation. Kurz gesagt: eine semantische Datenbank. Du lädst Inhalte rein, das System zerlegt sie in kleine Einheiten (sogenannte Chunks), und wenn du eine Frage stellst, sucht es die passenden Chunks heraus und lässt ein LLM darauf eine Antwort formulieren; wenn du möchtest auch gleich mit Quellenangabe. Das Entscheidende: Das System antwortet auf deiner Faktenbasis, nicht auf dem allgemeinen Internet-Wissen.
Je nach Einstiegslevel hast du drei Wege:
- Einstiegsebene: Notebook LM von Google. Kostenlos, in zehn Minuten einsatzbereit. Du lädst bis zu mehrere hundert Dokumente hoch und kannst sie befragen. Notebook LM generiert auf Wunsch auch Artikel, FAQ-Listen oder die berühmten Podcast-Dialoge — alles nur auf deinen hochgeladenen Inhalten, mit Quellenverweis. Wenn du noch nichts mit RAG gemacht hast: hier anfangen.
- Mittlere Ebene: Eigenes GPT oder Gemini-Gem. Wenn Notebook LM zu generisch wird, baust du dir ein eigenes GPT (in ChatGPT) oder ein Gem (in Gemini). Vorteil: Du kannst Rolle, Ton und Grenzen präziser definieren. Hier gilt die wichtigste Regel: weniger ist mehr. Lieber 20 hochwertige Dokumente reinlegen als 200 durchschnittliche. Qualität der Quellen schlägt Menge.
- Komplexe Ebene: Eigenes RAG. Wenn du Unabhängigkeit willst, baust du es selbst. Das ist technisch anspruchsvoller, aber nicht unmöglich — N8N, Qdrant, ein Embedding-Modell, ein LLM deiner Wahl. Damit gehören die Daten dir, du bestimmst das Modell, und du kannst das System anderen zur Verfügung stellen.
Es gibt auch weitere Möglichkeiten. So kannst du deine Wissensdatenbank etwa mit Notion aufbauen oder auch Google Docs oder sogar Apple Notes können von manchen LLM befragt und zur Produktion von Inhalten herangezogen werden.
Der Smoke-Test für jedes RAG
Damit du dich auf dein RAG auch wirklich verlassen kannst, solltest du es testen. Leg also auch Informationen rein, die nirgendwo sonst im Netz stehen. Erfundene Namen, fiktive Regeln, ausgedachte Preise. Dann frage das System gezielt danach. Wenn es korrekt antwortet, funktioniert der Retrieval-Teil. Danach frage nach etwas, das nicht drin ist.
Wenn es ehrlich „weiß ich nicht“ sagt, kannst du dem System vertrauen. Wenn es halluziniert, hast du ein Problem, das du lösen musst, bevor du live gehst.
Deine Checkliste zum Anfangen
Wenn du aus diesem Text nur eins mitnimmst, dann diese Fragen. Beantworte sie — für dich selbst, für dein Team, für deine Redaktion:
- Worin bin ich (oder sind wir) wirklich Expert:in?
- Über welche Inhalte verfüge ich schon — inklusive Recherchen, die in Schubladen liegen?
- Was ist meine Nische? Was ist der Twist, der mich von anderen unterscheidet?
- Welche drei Ecken hat mein Dreieck — und welche Tools besetzen sie?
- Was will ich nicht machen? (vielleicht kein Podcast, kein Video, kein LinkedIn — alles legitim.)
- Womit will ich am Ende Geld verdienen — und wie weit ist der Weg dahin?
Schreib dir die Antworten auf. Prompte sie dann in Claude und bitte um die Denkfehler. Überarbeite. Dann fang an — klein, mit einem Kanal, einem RAG, einem Experiment.
Der entscheidende Punkt: Die Bedrohung durch KI wird nicht durch einen heroischen Relaunch geringer. Sie wird kleiner durch eine andere Architektur — und durch die Bereitschaft, Content nicht mehr als Endprodukt zu denken, sondern als Rohstoff, aus dem immer wieder Neues entsteht.
Schreibe einen Kommentar